Spring 레거시 프로젝트에서 프롬프트 관리를 코드와 분리한 이유
기존 시스템 AX의 프롬프트 운영 병목#
기존 Spring 기반 레거시 프로젝트에 AI Transformation, 즉 AX 기능을 추가하면서 가장 먼저 요구받은 것은 완벽한 플랫폼 설계보다 고객이 사용할 기능을 빠르게 출시하는 일이었습니다. 이미 운영 중인 API 계약과 배포 절차를 크게 흔들 수 없었기 때문에, 초기에는 프롬프트를 코드에 넣고 정해진 모델을 호출하는 방식을 택했습니다.
하지만 AX 기능의 품질은 API가 200을 반환하는지만으로 판단할 수 없었습니다. 기획자가 기대한 문장 구조와 정보의 우선순위, 고객이 실제 업무에 사용할 만큼의 구체성, 사실관계와 출력 형식을 계속 확인하며 프롬프트를 조정해야 했습니다. 프롬프트가 코드에 묶여 있으니 단어 하나를 바꿀 때마다 개발자 수정과 코드 리뷰, 배포가 필요했고, 실험 속도가 제품 학습 속도를 따라가지 못했습니다.
프롬프트 튜닝을 개발자의 감각만으로 진행하는 것도 한계가 있었습니다. 기획자가 원하는 결과를 “좀 더 자연스럽게” 또는 “고객에게 도움이 되게”라고 표현하면 수정 방향은 잡을 수 있지만, 변경 전후를 비교하거나 회귀를 막으려면 요구를 과업 충족도, 정보 누락, 사실 일관성, 톤, 출력 형식처럼 반복해서 적용할 수 있는 평가 기준으로 바꿔야 했고, 한두 개의 예시를 눈으로 확인하는 단계를 넘어 동일한 데이터와 기준으로 여러 프롬프트 버전을 비교할 수 있어야 했습니다.
Langfuse 선정 기준#
Langfuse는 프롬프트 관리부터 테스트, 배포, 관측, 평가까지 하나의 흐름으로 연결할 수 있다는 점에서 선택했습니다. 기획자나 도메인 담당자는 코드와 배포 파이프라인에 접근하지 않고도 Playground에서 입력값을 바꿔가며 프롬프트와 모델 설정을 비교할 수 있습니다. 개발자는 실제 호출에 사용된 프롬프트 버전과 모델, 지연 시간과 성공 여부를 Trace와 Generation에서 확인할 수 있습니다.
Spring 애플리케이션에서는 Prompt Service와 Trace Service를 분리해 비즈니스 코드가 Langfuse SDK에 직접 종속되지 않게 했습니다. 기획자가 수정한 프롬프트는 development 라벨과 비식별 평가 데이터셋에서 먼저 검증하고, 같은 기준으로 변경 전후를 비교한 뒤 승인된 버전에만 production 라벨을 붙여서 관리하는 전략을 세웠습니다.
기획 요구는 평가 rubric으로 구체화해 비식별 데이터셋에 LLM-as-a-Judge를 적용했고, 운영 요청에서는 민감한 입력과 출력 원문 대신 길이·상태·버전만 비동기로 전송했습니다. Langfuse가 일시적으로 응답하지 않거나 프롬프트를 찾지 못하는 경우에는 환경별 fallback과 NoOp 구현이 기존 서비스의 동작을 유지하도록 했습니다.
기획·개발 역할 분담#
| 역할 | 담당하는 결정 | Langfuse에서 사용하는 기능 |
|---|---|---|
| 기획자·도메인 담당자 | 고객에게 필요한 정보, 허용할 톤과 형식, 실패로 볼 조건 | Prompt Management, Playground, 평가 rubric |
| 개발자 | 프롬프트 조회, 모델 호출, 장애 격리, 개인정보 보호 | Java client adapter, label fallback, Trace·Generation |
| 공동 검증 | 변경 전후의 과업 충족도·누락·사실 일관성 비교 | Dataset, LLM-as-a-Judge, version별 score |
고객가치의 평가 기준화#
“고객에게 도움이 되는 답변”은 그대로는 자동 평가할 수 없기 때문에, 기획자가 기대하는 고객 행동과 실패 사례를 먼저 적고 이를 출력에서 관찰할 수 있는 조건으로 바꿨으며, 아래 항목은 특정 점수를 보편적인 정답으로 삼기 위한 것이 아니라 프롬프트 버전마다 같은 질문을 반복해 회귀 여부를 확인하기 위한 rubric의 출발점으로 사용했습니다.
| 제품 관점의 요구 | 평가 질문 | 점수 형태 |
|---|---|---|
| 고객이 필요한 정보를 한 번에 얻는다 | 필수 정보와 다음 행동이 누락되지 않았는가 | Boolean 또는 1~5 |
| 신뢰할 수 있는 답변을 제공한다 | 입력에 없는 사실을 만들어내거나 근거를 과장하지 않았는가 | Boolean 또는 1~5 |
| 후속 가공 없이 바로 사용한다 | 약속한 JSON·표·문장 구조와 길이를 지켰는가 | Boolean |
| 제품의 커뮤니케이션 기준을 지킨다 | 대상 사용자에게 적절한 용어와 톤을 사용했는가 | 1~5 |
프롬프트를 UI에서 고칠 수 있다는 사실만으로 협업이 완성되는 것은 아니므로, 기획자가 먼저 “좋은 답변”의 조건과 실패 예시를 작성하고 개발자가 이를 입력·출력·정답 데이터 구조와 연결한 뒤, 사람이 판정한 소규모 기준 데이터로 평가 모델의 점수를 보정하는 절차를 함께 두었습니다.
LLM-as-a-Judge는 톤이나 유용성처럼 코드로 판정하기 어려운 항목을 같은 rubric으로 반복 평가하는 데 유용하지만 그 점수 자체가 고객가치를 증명하지는 않기 때문에, 당연히 최종 선정은 사람의 검토와 제품 지표를 함께 보도록 했습니다.
생각보다 글이 길어져서 이 글에서는 평가 결과를 실제 호출의 프롬프트 버전과 연결하는 지점까지만 다루며, 평가 모델과 반복 횟수까지 고정해야 점수를 비교할 수 있는 이유는 프롬프트를 고칠수록 LLM-as-a-Judge 점수는 올랐는데, 무엇이 효과가 있었을까에서 별도로 정리했습니다.
또한 운영 트레이스의 원문을 저장하지 않는 보안 정책과 LLM-as-a-Judge가 평가할 텍스트를 필요로 한다는 요구가 충돌하지 않도록, 실제 고객 요청은 메타데이터만 롤업하고 평가에는 별도로 비식별 처리한 입력·기대 출력 데이터셋을 사용했습니다. 덕분에 기획자는 고객 데이터에 직접 접근하지 않고도 대표 시나리오에서 프롬프트를 비교할 수 있고, 운영에서는 프롬프트 버전별 성공률·지연 시간·오류 유형만 추적할 수 있습니다.
Langfuse 적용 범위#
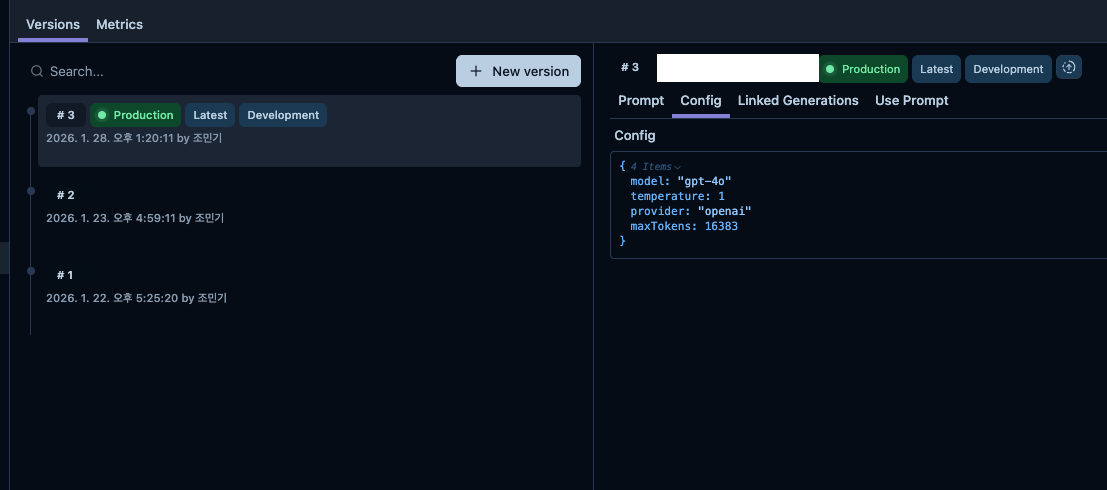
프롬프트 관리 — 대시보드에서 프롬프트를 등록하고 버전별 diff와 환경 라벨(production, development)을 관리하므로, 애플리케이션은 프롬프트 이름과 라벨만으로 사용할 버전을 결정하고 기획자는 배포를 기다리지 않고 Playground에서 후보 버전을 검증할 수 있습니다. 모델명과 temperature 같은 실행 설정도 프롬프트 버전에 함께 묶어두면 문구와 모델 조건이 따로 변경돼 비교 결과가 흐려지는 일을 줄일 수 있습니다.
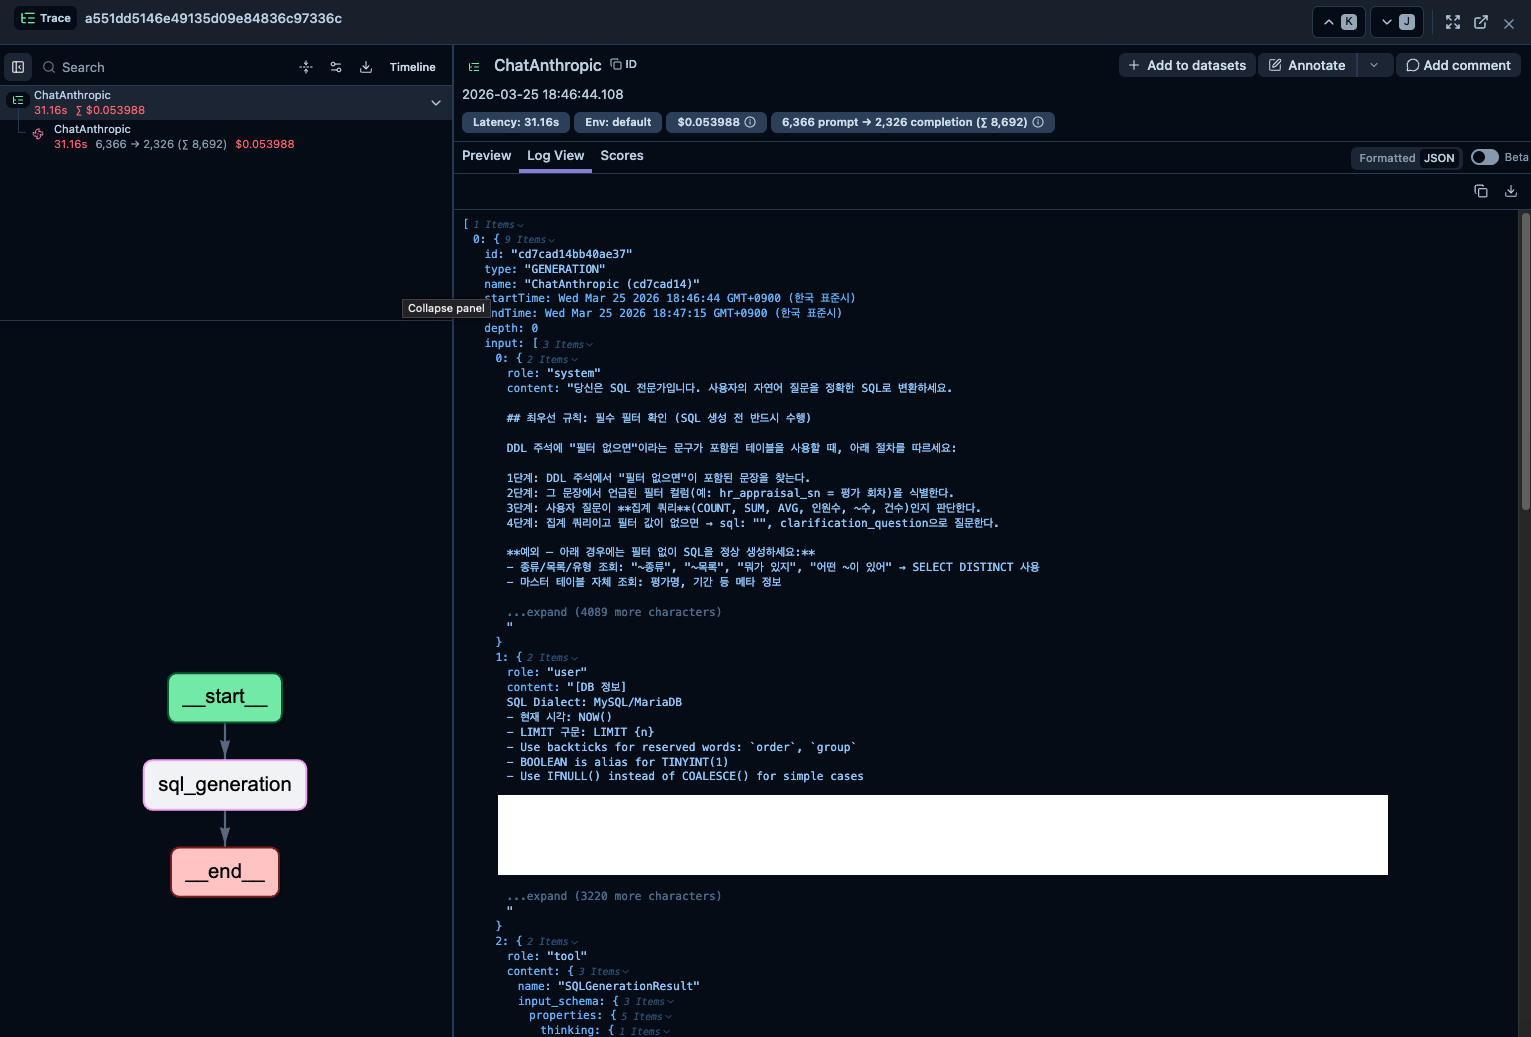
트레이싱과 평가 — 사용자 요청이나 배치 작업을 Trace로, 그 안의 개별 모델 호출을 Generation으로 기록한 뒤 프롬프트 이름·버전·모델·지연 시간·상태를 연결하면 어떤 변경이 성능과 오류율에 영향을 줬는지 추적할 수 있으며, 비식별 평가 데이터셋에서는 같은 실행 결과에 사람의 score나 LLM-as-a-Judge score를 붙여 품질 변화까지 함께 비교할 수 있습니다.
통합 아키텍처#
구조는 운영 요청을 처리하는 실행 경로와 프롬프트를 개선하는 튜닝 경로로 나눴습니다. 비즈니스 서비스는 기존과 동일하게 LLMService만 호출하고, 그 안에서 Prompt Service가 검증된 버전을 가져오며 Trace Service가 민감정보를 제거한 실행 메타데이터를 비동기로 전송하는 반면, 기획자와 개발자는 비식별 평가 데이터셋을 Playground와 LLM-as-a-Judge에 연결해 후보 프롬프트를 비교하고 승인된 버전에만 운영 라벨을 부여합니다.
이 구조에서 Langfuse는 프롬프트와 평가 기준을 운영하는 제어면이자 실행 결과를 확인하는 관측 계층이지만, 사용자 요청을 완료하기 위해 반드시 성공해야 하는 핵심 데이터 저장소는 아닙니다. 따라서 프롬프트를 읽지 못했을 때 기존 서비스가 어디까지 기능을 유지할지와 관측 이벤트가 전송되지 않았을 때 무엇을 유실로 허용할지는 서로 다른 정책으로 다뤘고, 이 구분을 코드에서도 Prompt Service와 Trace Service라는 별도 인터페이스로 유지했습니다.
기획 요구와 개발 계약을 연결하는 프롬프트 운영 체계#
Langfuse를 연동하기 전에 기획자와 먼저 합의한 것은 좋은 답변의 기준과 프롬프트 변경 범위였습니다. 고객에게 필요한 정보와 허용할 표현, 실패로 판단할 사례를 정리한 뒤, 이를 프롬프트 이름과 입력 변수, 출력 스키마, 허용할 모델 설정처럼 애플리케이션이 검증할 수 있는 계약으로 구체화했습니다. 이 경계를 정해두면 기획자는 계약 안에서 프롬프트를 직접 개선하고, 서비스의 입출력 구조는 안정적으로 유지할 수 있습니다.
새 버전은 곧바로 운영에 반영하지 않고 development 라벨에서 비식별 평가 데이터셋과 합의한 rubric으로 기존 버전과 비교했습니다. 평가 결과를 함께 검토한 뒤 승인된 버전에만 production 라벨을 부여했으며, 라벨 변경도 실제 고객 응답을 바꾸는 배포로 보고 변경자와 평가 결과, 롤백할 이전 버전을 기록했습니다.
Spring 애플리케이션은 합의된 이름과 라벨로 프롬프트를 조회하고, 실제 호출에 사용한 버전을 실행 메타데이터에 남겼습니다. 이를 기준으로 기획 단계에서 검토한 결과와 운영에서 고객에게 제공된 결과가 같은 프롬프트 버전에서 나온 것인지 추적할 수 있었습니다.
의존성 구성#
아래 코드는 이 글을 작성할 때 사용한 Java 클라이언트 API를 기준으로 작성했습니다. Langfuse SDK는 비교적 빠르게 변경되므로, 새 프로젝트라면 공식 Java 클라이언트의 현재 버전과 API를 확인한 뒤 적용해야 합니다. 버전만 최신으로 올리고 예제 코드를 그대로 복사하면 컴파일은 물론 이벤트 의미도 달라질 수 있습니다.
Maven과 Gradle 모두 com.langfuse:langfuse-java를 추가하면 됩니다. 버전은 BOM 또는 의존성 잠금 파일로 관리하고, 기존 HTTP 클라이언트와 전이 의존성 충돌이 없는지 확인합니다. 특히 SDK가 사용하는 HTTP 클라이언트를 애플리케이션 전역 빈과 무심코 공유하면 timeout·connection pool 정책이 서로 영향을 줄 수 있습니다.
참고: Spring AI를 이미 사용한다면 OpenTelemetry 연동으로 자동 계측을 붙일 수 있습니다. 반면 프롬프트 조회 정책, 모델 선택, 데이터 마스킹을 세밀하게 통제해야 한다면 이 글처럼 별도 어댑터를 두는 방식이 적합합니다.
클라이언트 구성과 자원 격리#
클라이언트 빈에서는 비밀값을 외부에서 주입하고 Langfuse 전용 HTTP 자원을 다른 외부 API와 분리하는 동시에, 기능을 사용하지 않는 환경에서는 실제 클라이언트 자체가 생성되지 않도록 조건을 걸어 설정 누락이나 관측 시스템 장애가 기존 애플리케이션의 기동 조건으로 번지지 않게 합니다.
@Configuration
@ConditionalOnProperty(prefix = "langfuse", name = "enabled", havingValue = "true")
public class LangfuseConfig {
    @Bean
    LangfuseClient langfuseClient(LangfuseProperties properties,
                                  @Qualifier("langfuseHttpClient") OkHttpClient httpClient) {
        return LangfuseClient.builder()
                .url(properties.baseUrl())
                .credentials(properties.publicKey(), properties.secretKey())
                .httpClient(httpClient)
                .timeout(10)
                .build();
    }
}@ConditionalOnProperty는 명시적으로 기능을 켰을 때만 실제 클라이언트를 만들게 합니다. 로컬 환경에서 키가 없다는 이유만으로 애플리케이션 기동이 실패하지 않게 하려는 장치이며, 비활성화 상태의 동작은 뒤에서 NoOp 구현으로 보완합니다.
OkHttp 연결 풀을 별도 빈으로 두는 이유는 Langfuse의 timeout·커넥션 수를 LLM provider나 일반 외부 API와 독립적으로 조정하기 위해서입니다. 이 값은 추정으로 정하지 말고, 이벤트 전송량·서버 응답 시간·애플리케이션의 동시 요청 수를 기준으로 부하 테스트에서 검증해야 합니다.
애플리케이션 설정#
설정은 enabled, base-url, public-key, secret-key, HTTP timeout과 connection pool처럼 운영에서 조정할 값만 외부화했습니다. 키는 환경변수나 AWS Parameter Store 같은 비밀 저장소에서 주입하고, Public Key도 프로젝트 식별에 사용되므로 평문 로그에 남기지 않습니다. 상태 점검이 필요하면 실제 값이 아니라 설정 여부만 기록합니다.
프롬프트 제어 계층#
프롬프트를 코드 밖에서 관리하더라도 애플리케이션 전체가 Langfuse SDK의 응답 모델에 종속되어서는 안 되므로, 프롬프트 이름·입력 변수·fallback 정책을 받아 렌더링된 텍스트와 모델 설정·버전 메타데이터를 반환하는 얇은 계층을 두고, 외부 SDK 타입을 해석하는 책임을 이 경계 안으로 모았습니다.
Langfuse에서는 프롬프트 버전의 diff를 확인하고 특정 버전에 production 라벨을 부여할 수 있습니다. 애플리케이션이 특정 숫자 버전을 코드에 고정하지 않고 라벨을 조회하면, 배포와 프롬프트 승격의 주기를 분리할 수 있습니다. (공식 문서: Prompt Management)
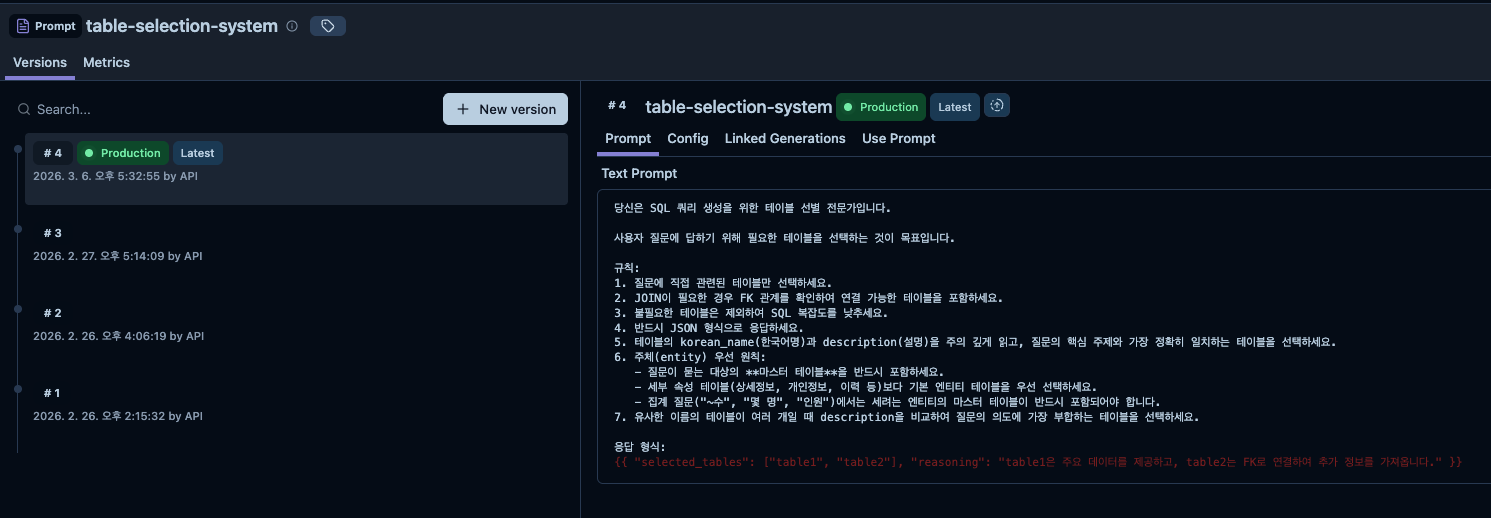
여기서 중요한 점은 프롬프트가 단순 문자열이 아니라는 것입니다. 프롬프트 버전, 모델 설정, 선택된 라벨을 함께 보존해야 나중에 동일한 호출을 설명할 수 있습니다.
프롬프트 조회 인터페이스#
public interface LangfusePromptService {
    PromptWithConfig resolvePrompt(LLMPromptRequest request);
}

public record PromptWithConfig(
    String promptText,
    PromptConfigData config,
    String promptName,
    Integer promptVersion
) {}
반환 타입인 PromptWithConfig에는 렌더링된 텍스트뿐 아니라 Langfuse에서 설정한 모델 정보와 버전을 담습니다. LLM 실행 계층은 이 타입만 받아서 모델을 선택하고 트레이스에 같은 버전을 남깁니다.
PromptConfigData는 Langfuse 프롬프트에 붙여둔 config를 담는 객체입니다. 다만 provider나 model을 원격 config에서 바꿀 수 있다는 것은 운영 권한을 넓힌다는 뜻이기도 합니다. 허용된 provider·model 목록을 애플리케이션에서 검증하고, 비용·보안 정책에 영향을 주는 값을 무제한으로 신뢰하지 않아야 합니다.
프롬프트 요청 모델#
LLMPromptRequest에는 프롬프트 이름, 템플릿 변수, 장애 시 사용할 fallback 프롬프트를 담았습니다. 이 모델은 SDK 요청 객체가 아니라 비즈니스 계층과 프롬프트 제어 계층 사이의 계약이므로, 외부 라이브러리가 바뀌어도 호출부에는 영향을 주지 않습니다.
fallbackPrompt는 Langfuse를 조회할 수 없을 때 사용할 최소 기능용 프롬프트입니다. 모든 기능에 fallback이 정답은 아닙니다. 결과의 정확성이나 감사 추적이 중요한 기능이라면, 오래된 지시문으로 응답하는 것보다 명시적으로 실패시키는 편이 낫습니다. 기능별로 fallback 가능, 캐시된 마지막 정상 버전 사용, 요청 실패 중 하나를 정책으로 정하고 테스트해야 합니다.
Java SDK에 프롬프트 변수 치환을 추가했다#
Langfuse 프롬프트 안의 {{variableName}}을 요청 값으로 바꾸는 기능은 처음에 애플리케이션 안에서 직접 구현했습니다. Matcher.quoteReplacement를 사용해 값에 포함된 $와 \가 정규식 치환 문법으로 해석되지 않게 했고, 필요한 변수가 빠지면 프롬프트 계약 위반으로 처리했습니다.
Text Prompt와 Chat Prompt가 같은 변수 문법을 사용하는데도 프로젝트마다 이 처리를 반복하는 것은 아쉬웠습니다. Python과 JavaScript SDK에서 제공하던 compile()과 같은 기능이 Java SDK에도 있으면 좋겠다고 생각해, 변수명 추출과 Text·Chat Prompt 컴파일을 지원하는 기능을 Langfuse Java SDK에 기여했습니다. 누락된 변수와 null, 중복 변수, 공백이 포함된 표현, 닫히지 않은 괄호 같은 경우를 테스트했고 해당 PR은 공식 저장소에 병합됐습니다.
Langfuse Java 클라이언트는 Fern으로 생성되기 때문에 기능을 추가할 위치도 확인해야 했습니다. 직접 작성한 코드가 SDK 재생성 과정에서 사라지지 않도록 생성 대상 패키지 밖에 구현하고, Fern을 다시 실행해 파일이 유지되는지 확인했습니다.
SDK의 PromptCompiler는 전달되지 않은 변수를 원래의 {{variableName}} 형태로 남깁니다. 반면 이 서비스에서는 치환되지 않은 변수가 LLM 요청까지 전달되지 않도록 필요한 변수 목록과 요청 값을 별도로 검증합니다. 공통 SDK가 제공하는 치환 동작과 서비스가 요구하는 엄격한 입력 계약을 같은 것으로 보지 않았습니다.
환경 라벨 조회와 오류 분류#
프로덕션과 개발 환경에서 서로 다른 프롬프트를 사용하려면 라벨 기능을 이용합니다. 라벨 자체는 버전의 별칭일 뿐, 애플리케이션에 맞는 우선순위나 장애 정책까지 해결해주지는 않습니다. 이 글에서는 환경별 우선순위를 애플리케이션에 둡니다.
개발 환경에서는 development → production → latest 순서, 프로덕션에서는 production → latest 순서로 조회합니다. 새 프롬프트에 개발 라벨이 아직 없더라도 검증을 계속할 수 있고, 운영 라벨이 없는 프롬프트는 의도치 않게 개발 버전을 사용하지 않습니다.
다만 후보 라벨을 바꿔 재시도할 수 있는 경우는 해당 라벨의 프롬프트가 존재하지 않을 때뿐입니다. 인증 실패, timeout, rate limit, 네트워크 단절은 라벨을 바꿔도 해결되지 않습니다. 이런 오류까지 반복하면 장애 시간을 후보 수만큼 늘리고, 실제 원인을 흐립니다.
아래처럼 NotFoundError만 다음 라벨로 넘기고 나머지는 즉시 실패로 분류합니다.
for (PromptLabel label : labels) {
    try {
        return fetchFromLangfuse(key, label);
    } catch (NotFoundError e) {
        // 이 라벨만 없는 것이므로 다음 후보를 본다
    } catch (Exception e) {
        throw new PromptLoadException(key.promptName(), e);
    }
}
후보가 모두 없으면 그때만 fallbackPrompt 또는 캐시된 마지막 정상 버전을 사용합니다. 외부 서비스 자체가 응답하지 않을 때는 fallback 여부를 기능 정책에 맡깁니다. 캐시와 결합한 구체적인 동작은 다음 편에서 다룹니다.
어떤 환경에서 어느 체인을 쓸지는 Spring 프로필 문자열을 코드에서 직접 비교하지 않고 전용 설정 프로퍼티로 주입했습니다. 이렇게 해야 배포 환경 이름과 프롬프트 정책이 불필요하게 결합되지 않습니다.
프롬프트 서비스 구현#
실제 서비스 구현은 위의 오류 분기 뒤에 SDK 응답 변환과 변수 치환을 연결합니다. 코드 전체를 옮기면 외부 SDK의 builder와 응답 타입이 대부분을 차지하므로 생략했으며, 핵심 계약은 성공한 조회에서 프롬프트 텍스트·모델 설정·버전을 PromptWithConfig로 묶어 반환하고, 후보 라벨이 모두 없을 때만 기능별 fallback 정책을 적용하는 것입니다.
SDK 응답 모델 변환#
PromptExtractor는 SDK가 반환한 Text·Chat 타입을 애플리케이션의 PromptWithConfig로 변환하는 어댑터입니다. 이때 Chat 메시지를 하나의 문자열로 합치면 system·user·assistant 역할이 사라지므로, 실제 Chat API에서는 List<ChatMessage>를 유지한 채 provider 요청으로 넘겼습니다. 원격 config에 필드가 추가되는 상황은 허용하되 provider와 model 같은 필수 필드는 별도로 검증해, 잘못된 기본값으로 호출이 이어지지 않게 했습니다.
LLM 호출 관측 모델#
프롬프트 관리만으로는 결과가 왜 달라졌는지 알 수 없습니다. 관측 데이터는 최소한 프롬프트 버전, 모델, 지연 시간, 상태, 요청 상관관계를 연결해야 합니다. 입력·출력 전문은 가장 유용한 디버깅 정보이면서 가장 민감한 데이터이기도 하므로, 무조건 기록하지 않습니다. (공식 문서: Observability)
Trace와 Generation#
Langfuse의 트레이싱 데이터 모델은 다음 두 단위로 구분합니다.
- Trace: 사용자 요청이나 배치 작업처럼 하나의 업무 흐름을 나타내는 상위 단위
- Generation: Trace 안에서 일어난 개별 모델 호출. 체인·재시도·도구 호출이 있다면 하나의 Trace에 여러 개가 생길 수 있음
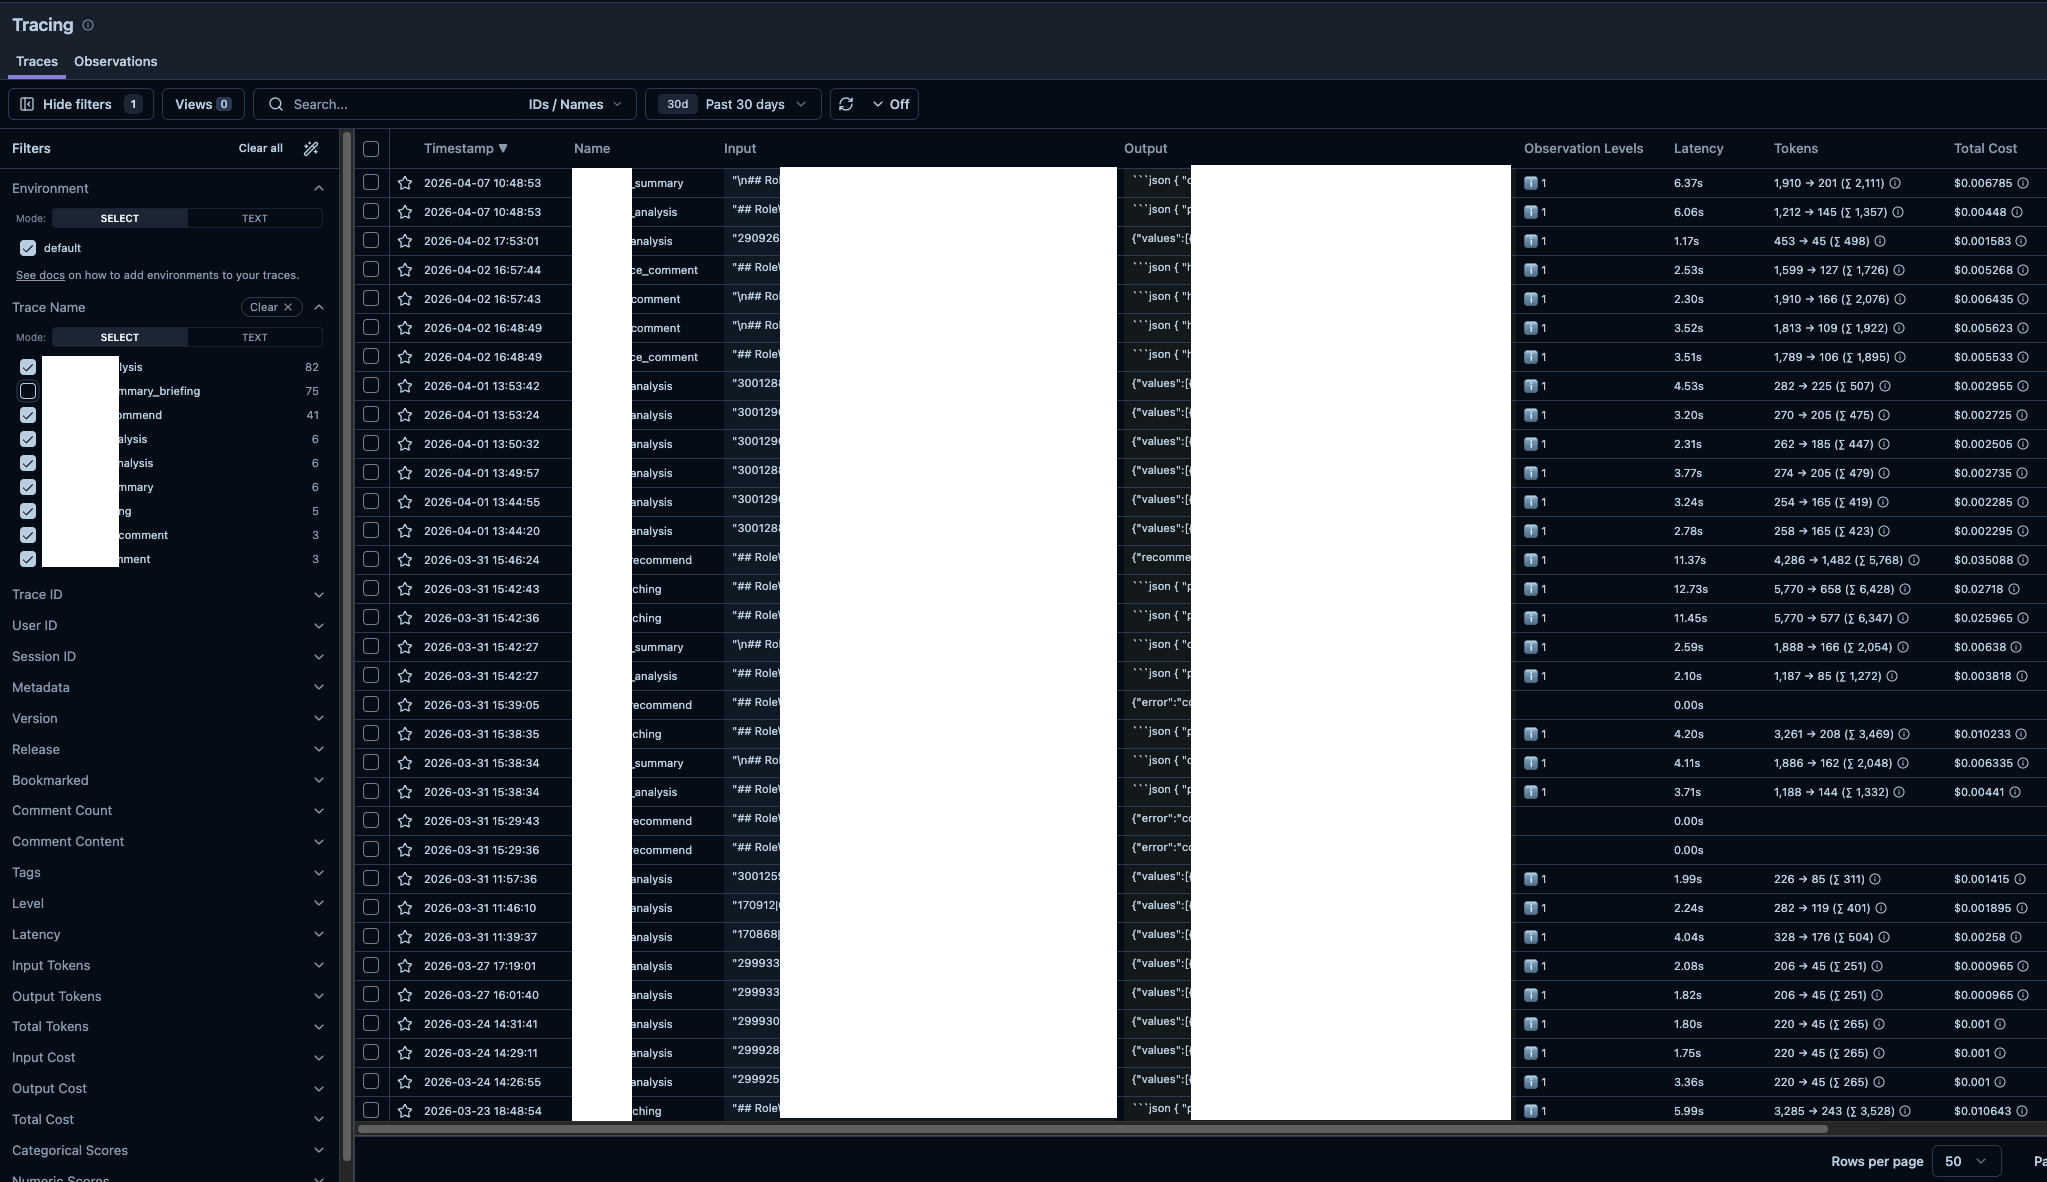
Trace ID는 HTTP 요청 ID나 작업 ID와 연결해 두면 애플리케이션 로그와 대시보드를 왕복하기 쉽습니다. 대시보드에서는 Trace 목록을 보고, 세부 화면에서 Generation별 모델·지연 시간·상태를 확인할 수 있습니다.
관측 요청 모델#
public record TraceInputSummary(
    int messageCount,
    int promptCharacters
) {}

public record TraceOutputSummary(
    int responseCharacters,
    String status,
    String errorType
) {}
Generation 이벤트에는 이 요약값과 함께 trace ID, 모델, 프롬프트 이름·버전, 모델 호출 직전의 시작 시각을 담았습니다. SDK 이벤트 생성 시각이 아니라 실제 호출 구간을 기준으로 지연 시간을 계산하기 위해서이며, 스트리밍 응답이라면 첫 토큰과 마지막 토큰 시각도 별도로 구분해야 합니다.
관측 payload에는 입력과 응답 원문을 넣지 않고 메시지 수, 시스템 프롬프트 길이, 응답 길이, 성공 여부와 예외 타입만 전송하며, 문제 재현을 위해 원문이 필요한 경우에도 일반 Trace에 섞지 않고 별도 승인·보존 기간·접근 권한을 적용한 제한 경로로 분리합니다.
비동기 트레이스 전송#
관측 계층이 비즈니스 요청의 임계 경로를 늘리지 않도록 요청 스레드는 bounded queue에 이벤트만 넣고 즉시 반환하며, 스케줄러가 별도 스레드에서 이벤트를 모아 배치 전송하기 때문에 Langfuse의 응답이 느리거나 일시적으로 실패하더라도 고객에게 반환할 LLM 응답은 관측 데이터의 전송 완료를 기다리지 않습니다.
@Service
public class LangfuseTraceServiceImpl implements LangfuseTraceService {
    private final LangfuseClient langfuseClient;
    private final Counter droppedEvents;
    private final BlockingQueue<IngestionEvent> queue = new ArrayBlockingQueue<>(1_000);
    private static final int BATCH_SIZE = 10;

    public void enqueue(IngestionEvent event) {
        if (!queue.offer(event)) {
            droppedEvents.increment();
        }
    }

    @Scheduled(fixedDelayString = "${langfuse.trace.flush-interval-ms:500}")
    void flush() {
        List<IngestionEvent> events = new ArrayList<>(BATCH_SIZE);
        queue.drainTo(events, BATCH_SIZE);
        if (events.isEmpty()) return;

        try {
            langfuseClient.ingestion().batch(
                IngestionRequest.builder().batch(events).build()
            );
        } catch (Exception e) {
            log.error("[LangfuseTrace] flush 실패", e);
        }
    }
}ArrayBlockingQueue로 큐 용량을 고정하면 Langfuse 장애가 무제한 메모리 사용으로 번지는 것을 막을 수 있으며, 큐가 가득 찼을 때는 고객 요청을 지연시키는 대신 새 관측 이벤트를 버리고 droppedEvents를 올리도록 했습니다. 이 데이터는 서비스 디버깅을 위한 best-effort 관측 정보이므로 일부 유실을 허용하지만, 모든 이벤트를 보존해야 하는 감사 로그라면 같은 정책을 재사용하지 않고 별도 영속 큐를 선택해야 합니다.
@Scheduled를 사용하려면 애플리케이션에 @EnableScheduling이 필요하고, 종료 시에는 graceful shutdown 경로에서 남은 이벤트를 정해진 제한 시간 안에 비우되 이 동기 flush는 종료 단계에서만 실행하도록 제한해 사용자 요청 스레드가 관측 전송을 기다리는 경로를 만들지 않습니다.
비활성 환경의 NoOp 구현#
로컬 개발, 통합 테스트, 일부 배치 환경에서는 Langfuse 키나 네트워크 연결이 없을 수 있습니다. 이때 Langfuse 설정 누락이 애플리케이션 기동 실패로 이어지면 개발 경험과 테스트 격리 모두 나빠집니다. 비활성화 환경에는 동일한 인터페이스를 구현하되 외부 호출을 하지 않는 NoOp 구현을 주입합니다.
Prompt Service의 NoOp은 fallback 프롬프트를 반환하고, Trace Service의 NoOp은 같은 메서드 계약을 유지한 채 이벤트를 만들거나 전송하지 않습니다. 두 구현 모두 @ConditionalOnProperty(..., matchIfMissing = true)로 등록해 설정이 없으면 외부 통신을 하지 않고, 운영 환경에서만 실제 구현을 활성화했습니다.
이 구조의 핵심은 호출부가 활성화 여부를 판단하지 않는 데 있습니다. 호출부는 인터페이스만 의존하고, Spring 조립 단계에서 실제 구현체 또는 NoOp을 선택합니다. if (langfuseEnabled)가 비즈니스 코드 곳곳에 퍼지는 것을 막을 수 있습니다.
| 설정 | Prompt Service | Trace Service |
|---|---|---|
enabled=true, trace.enabled=true | 실제 구현체 | 실제 구현체 |
enabled=true, trace.enabled=false | 실제 구현체 | NoOp |
enabled=false 또는 미설정 | NoOp | NoOp |
프롬프트는 Langfuse에서 가져오되 트레이싱만 끄는 식으로 기능별 독립 제어도 가능합니다. 단, 프롬프트 조회를 켰다면 실패 시 사용할 정책까지 함께 설정해야 합니다.
LLM 실행 계층 통합#
프롬프트 서비스와 트레이스 서비스는 실제 LLM 호출의 단일 진입점에서 조합합니다. 비즈니스 서비스가 트레이스 이벤트나 Langfuse SDK를 직접 만들지 않게 하는 것이 중요합니다.
public <T> T chat(LLMPromptRequest request,
                  Collection<LLMMessage> messages,
                  Class<T> responseType) {
    PromptWithConfig prompt = langfusePromptService.resolvePrompt(request);
    ChatModel chatModel = chatModelSelector.select(prompt.config());
    TraceContext trace = traceService.start(prompt, messages);

    try {
        String rawResponse = chatModel.call(prompt.promptText(), messages);
        traceService.complete(trace, TraceOutputSummary.success(rawResponse));
        return parseResponse(rawResponse, responseType);
    } catch (Exception e) {
        traceService.fail(trace, TraceOutputSummary.failure(e));
        throw e;
    }
}
실패한 호출도 재시도·fallback·provider 오류를 구분할 수 있도록 Generation과 Trace에 남기지만, messages, response, e.getMessage()는 계정 번호나 이메일, 문서 원문, API 키를 포함할 수 있으므로 외부로 전달하지 않고 앞서 정의한 TraceInputSummary와 TraceOutputSummary로 롤업합니다. 이 경계를 지나 Langfuse에 저장되는 값은 메시지 개수, 프롬프트·응답 길이, 성공 여부와 예외 클래스뿐이며, 관측용 DTO도 허용 필드만 명시적으로 추가하는 allowlist 방식으로 확장하고 요약에 실패하면 이벤트 자체를 버리는 fail-closed 정책을 적용해 관측 실패가 원래 LLM 응답이나 예외를 덮어쓰지 않게 했습니다.
비즈니스 계층의 프롬프트 식별#
여기까지가 인프라 계층입니다. 비즈니스 서비스에는 프롬프트 식별자·입력 변수·응답 타입만 남기고, Langfuse의 호출 방식은 노출하지 않습니다.
PromptId 기반 프롬프트 식별#
프롬프트 이름이나 fallback 텍스트를 서비스 코드에 문자열로 흩뿌리면 오탈자와 미사용 프롬프트를 찾기 어려워집니다. 도메인별 Enum으로 프롬프트 메타데이터를 한 곳에 모읍니다.
public interface PromptId {
    String promptName();
    default String fallbackPrompt() { return null; }
}

public enum SummaryPrompt implements PromptId {
    DOCUMENT_SUMMARY("document_summary", DOCUMENT_SUMMARY_FALLBACK),
    FEEDBACK_ANALYSIS("feedback_analysis", FEEDBACK_ANALYSIS_FALLBACK);
}
도메인별 Enum은 Langfuse에 등록된 이름과 fallback 정책만 관리합니다. 긴 fallback 본문을 예제에 다시 싣지는 않았지만, 실제 코드에서는 원격 프롬프트와 입력 변수·출력 스키마가 어긋나지 않는지 CI 계약 테스트로 검증합니다.
반대로 AI 브리핑처럼 부가 기능은 fallbackPrompt()의 기본값인 null을 유지해, Langfuse를 사용할 수 없을 때 검증되지 않은 지시문으로 결과를 만들지 않고 기능을 명시적으로 중단합니다.
비즈니스 서비스 호출#
비즈니스 서비스는 PromptId Enum과 LLMService만 알면 됩니다. Langfuse 연동의 상세, 라벨, 이벤트 전송, 마스킹 정책은 인프라 계층에 머뭅니다.
return llmService.chat(
    LLMPromptRequest.from(SummaryPrompt.DOCUMENT_SUMMARY)
        .variable("document", documentText),
    List.of(new LLMMessage.User(documentText)),
    SummaryResultDto.class
);
호출부는 프롬프트 식별자와 변수, 응답 타입만 넘깁니다. Langfuse 조회와 모델 선택, 관측 이벤트 생성은 LLMService 아래에 남기 때문에 비즈니스 서비스는 라벨이나 SDK 타입을 알 필요가 없습니다.
요청 처리 및 관측 흐름#
전체 요청은 하나의 LLMService 진입점을 통과하지만 프롬프트 조회, 모델 호출, 관측 이벤트 생성은 서로 다른 책임으로 분리되어 있으며, Trace는 모델 호출 전에 생성하고 완료 이벤트는 queue에 넣은 뒤 고객 응답을 먼저 반환하므로 아래 흐름에서 Langfuse로 향하는 마지막 배치 전송만 요청 처리와 비동기로 진행됩니다.
이 흐름을 유지하면 호출부는 LLMService만 의존한 채 Langfuse 활성화 여부나 이벤트 전송 방식을 알 필요가 없고, 환경에 따라 실제 구현체와 NoOp 구현체가 교체되더라도 동일한 비즈니스 코드를 사용하면서 실행 메타데이터에 남은 프롬프트 버전으로 결과의 차이를 추적할 수 있습니다.
운영 시에 검증해볼만한 항목들#
| 영역 | 확인할 항목 |
|---|---|
| 프롬프트 | 라벨 승격 절차, 변수 누락 시 동작, fallback 허용 기능이 정의됐는가 |
| 장애 | Not Found와 timeout·인증 오류가 다르게 처리되는가, Langfuse 장애가 요청 SLA를 침범하지 않는가 |
| 데이터 | 입력·출력·metadata의 허용 필드와 마스킹 기준이 문서화됐는가 |
| 성능 | 프롬프트 조회 캐시, 이벤트 queue 상한, 전송 timeout과 drop 메트릭이 있는가 |
| 검증 | 프롬프트별 입력 변수·출력 스키마·fallback 계약을 자동 테스트하는가 |
이 중 하나라도 비어 있다면 Langfuse는 편리한 대시보드에 그치고, 실제 운영 제어면이 되지는 못합니다.
후속 과제: 캐시와 장애 격리#
현재 구현은 요청을 처리하는 동안 Langfuse API에서 프롬프트를 조회하므로, 원격 호출의 지연과 장애가 LLM 응답 경로에 직접 영향을 줍니다. 프롬프트는 읽기 비중이 높고 같은 버전이 반복 사용되는 데이터이므로, 이 경로에는 별도의 캐시 정책이 필요합니다.
특히 cache miss가 겹치면 동일 프롬프트에 대한 원격 조회가 한꺼번에 몰릴 수 있고, Langfuse 장애 시 fallback 정책도 실제로 검증해야 합니다. 다음 글에서는 Redis 캐시, cache stampede 제어, 마지막 정상 값 활용을 어떻게 결합했는지 다룹니다.
Python과 JS/TS SDK는 기본 60초 TTL의 인메모리 프롬프트 캐시와 백그라운드 갱신을 제공하지만, 글 작성 시점에 사용한 Java 클라이언트에는 같은 기능이 공식적으로 제공되지 않았습니다. 다음 글에서는 여러 Spring 인스턴스가 함께 사용할 수 있도록 애플리케이션 계층에 Redis 캐시를 구성한 과정을 다룹니다.
참고 자료